Tres llamadas al LLM y ni una más
Construí una API que compara CVs con ofertas de trabajo usando IA. La regla que guió todo el diseño fue simple: el LLM es caro, los embeddings son baratos. El resultado es una API donde el LLM aparece en exactamente tres lugares, y en ninguno decide el número que importa.
Cuando construyes algo con IA, la tentación es pedirle todo al LLM: que lea, que compare, que decida y que ponga la nota. Funciona en la demo y se vuelve caro, lento y difícil de auditar en cuanto hay tráfico real.
En este proyecto partí de una regla simple: el LLM es caro, los embeddings son baratos. Todo lo demás salió de tomarme esa regla en serio. El resultado es una API donde el LLM aparece en exactamente tres lugares, y en ninguno de ellos decide el número que importa.
El proyecto
djobmatch es una API REST pequeña hecha con Django y Django Ninja, con Postgres y pgvector detrás. Tiene tres endpoints:
POST /api/jobs/parseconvierte el texto de una oferta en JSON: skills técnicas y blandas, seniority real, rango salarial y red flags.POST /api/resumes/parsehace lo mismo con un CV.POST /api/matchrecibe un CV y una oferta ya parseados y devuelve un score de 0 a 100 más una explicación.
El dominio da igual. Lo interesante es dónde está el LLM y dónde no.
Decisión 1: el LLM en tres lugares, ni uno más
El LLM solo hace lo que nada más barato puede hacer bien: entender texto desordenado y escribir prosa. Concretamente:
- Extraer el JSON de una oferta.
- Extraer el JSON de un CV.
- Redactar la explicación de un match.
Todo lo demás (comparar, puntuar, recordar) lo hacen embeddings, Postgres y código normal. Esta regla está escrita en el README y en el CLAUDE.md del repo, así que también la respeta cualquier agente que toque el código.
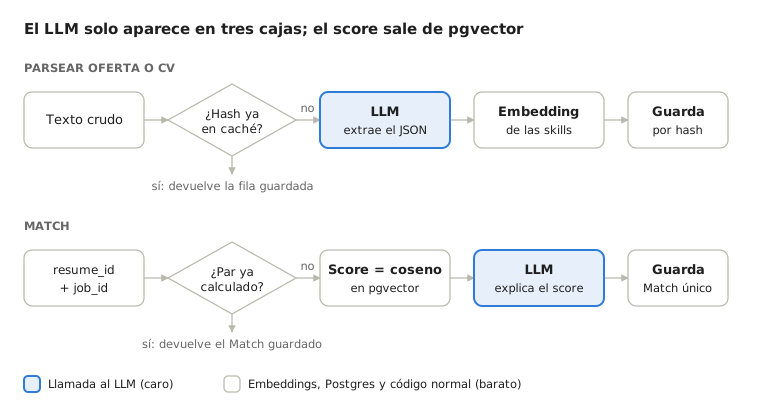
Las cajas en azul son las únicas que cuestan una llamada al LLM, y ninguna se ejecuta si el dato ya está en caché.
Decisión 2: el score no lo pone el LLM
El número de 0 a 100 sale de la distancia coseno entre dos embeddings, calculada dentro de Postgres con pgvector. El LLM no lo toca.
distance = (
    Resume.objects.filter(pk=resume.pk)
    .annotate(d=CosineDistance("embedding", job.embedding))
    .values_list("d", flat=True)
    .first()
)
similarity = 1.0 - float(distance)
score = round((similarity + 1) / 2 * 100)
Por qué importa:
- Determinista. El mismo par da siempre el mismo score. Un LLM con temperatura 0 tampoco te lo garantiza.
- Barato. Un embedding cuesta una fracción de una llamada de chat, y el coseno lo calcula la base de datos.
- Testeable.
similarity_to_scorees una función pura; se prueba sin red ni mocks.
Un detalle que marca la diferencia: no embebo el texto crudo. Embebo un texto canónico construido desde el JSON parseado (seniority + hard skills + soft skills). Así la oferta y el CV quedan en el mismo espacio y no compiten el estilo de redacción de un reclutador contra el de un candidato.
Decisión 3: caché en la base de datos, y tests que lo vigilan
Cada oferta y cada CV se guardan con un content_hash: el SHA-256 del texto con los espacios normalizados. Si llega el mismo texto otra vez, aunque tenga espacios de más, el servicio devuelve la fila existente y no llama a ningún proveedor.
Los matches siguen la misma idea: hay una restricción UNIQUE (resume, job), así que cada par se calcula una sola vez. Lo primero que hace cada servicio es mirar la caché, y todos devuelven (objeto, cached) para que el cliente sepa qué pasó.
Lo que hace que esto aguante en el tiempo son los tests. No solo verifican la respuesta: cuentan las llamadas al proveedor.
first = client.post("/match", json={"resume_id": resume.pk, "job_id": job.pk})
second = client.post("/match", json={"resume_id": resume.pk, "job_id": job.pk})

assert second.json()["cached"] is True
assert len(_patch_llm.calls) == 1  # not called on the cache hit
Si alguien añade una llamada al LLM en el camino de la caché, el costo sube en silencio. Con este test, el CI falla antes de que llegue la factura.
Decisión 4: el proveedor detrás de una interfaz
Ni los endpoints ni los servicios importan el SDK de OpenAI. Dependen de dos interfaces pequeñas:
class LLMProvider(abc.ABC):
    def complete_json(self, system_prompt: str, user_content: str) -> dict: ...

class EmbeddingProvider(abc.ABC):
    def embed(self, text: str) -> list[float]: ...
Una función get_llm() elige la implementación según la variable LLM_PROVIDER. Cambiar a Anthropic o a Voyage es escribir una clase y añadir una rama al factory.
La ventaja que más uso no es cambiar de proveedor, son los tests. Cada servicio acepta llm= y embedder= opcionales, así que la suite inyecta fakes que graban sus llamadas. Ningún test toca una API real.
Lo que todavía no resuelve
Esta arquitectura no es perfecta, y prefiero contarlo antes de que me lo digan:
- El score está sin calibrar. Convierto la similitud coseno de [-1, 1] a [0, 100] con una regla lineal. Pero los embeddings de texto casi nunca dan similitudes negativas y suelen moverse en un rango estrecho, así que lo esperable es que casi todo caiga en la mitad alta de la escala. Todavía no lo he medido con datos reales. Lo barato y determinista no es automáticamente lo correcto.
- La explicación hereda el score. El LLM recibe el número junto con los dos JSON, así que tiende a justificarlo en lugar de cuestionarlo. Es una explicación, no una segunda opinión.
- El embedding depende de la extracción. Si el LLM omite una skill al parsear, esa skill no existe para el score. El error de la etapa cara se arrastra a la barata.
Ninguno de estos problemas viene de la regla “el LLM es caro”. Son el siguiente paso: medir y calibrar.
Lecciones aprendidas
La primera es que la regla tiene que estar escrita antes que el código. Cuando puse “el LLM solo en tres lugares” en el README y en el CLAUDE.md, dejó de ser una intención mía y pasó a ser algo que cualquiera, incluido un agente, podía leer y respetar.
La segunda: un número que le vas a mostrar a alguien no debería depender de un modelo generativo. Si el mismo CV contra la misma oferta puede dar un score distinto cada vez, nadie va a confiar en ese score.
La tercera: cachear por contenido es más simple de lo que parece. Un SHA-256 del texto normalizado y una restricción UNIQUE en la base de datos alcanzaron, sin Redis ni colas.
Y la que más me sirvió: una regla de costo vale poco si nadie la vigila. Que los tests cuenten las llamadas al proveedor es lo que evita que esto se degrade con el tiempo.
El proyecto es pequeño a propósito: sin Celery, sin Docker, sin capas extra. Que la idea quepa en unos pocos archivos también fue una decisión. El código está en GitHub.
Comentarios